Stippl ist der soziale KI-Reiseplaner. Wir bauen ihn mit Coding-Agenten. Nichts, was sie schreiben, erreicht Reisende ohne Gates: Tests, die wir rot gesehen haben, einen Validator, der jede Aussage prüft, ein Review durch jemanden, der den Code nicht geschrieben hat, und einen QA-Durchlauf, bevor etwas gemergt wird. So ging unsere Redaktion in etwa 23 Stunden live, und so kam der eine Bug trotzdem durch.
Am 12. November um 16:37 Uhr sagte ich „go“ für Stippl News, den Bereich, den du gerade liest. Am nächsten Tag um 15:27 Uhr war er auf Englisch, Niederländisch und Deutsch live: ein Feed, Story-Seiten, Titelbilder, eine Synchronisation von einfachen Dateien auf die Website und der Job, der neue Stories entwirft. Sechs Arbeitspakete in einem Pull Request mit 55 Commits, geschrieben von Coding-Agenten. Über das Tempo reden alle. Es ist aber der am wenigsten interessante Teil.
Tempo war nie das Problem
Wir sind ein kleines Team, das einen KI-Reiseplaner für Menschen baut, die gemeinsam reisen. Agenten lassen uns in einem Tempo bauen, das ein Team unserer Größe nie erreichen könnte. Das Risiko ist das, über das die Branche dieses Jahr immer wieder spricht: Vibe Coding, also das Akzeptieren dessen, was das Modell schreibt, weil es läuft.
Ein Agent schreibt flüssigen Code und flüssige Erklärungen dazu. Beides klingt richtig. Keines von beiden ist ein Beleg. Deshalb ist für mich nicht die Frage entscheidend, wie gut das Modell ist, sondern was wahr sein muss, bevor seine Arbeit einen Reisenden erreicht, und welche Prüfungen das für uns sicherstellen.
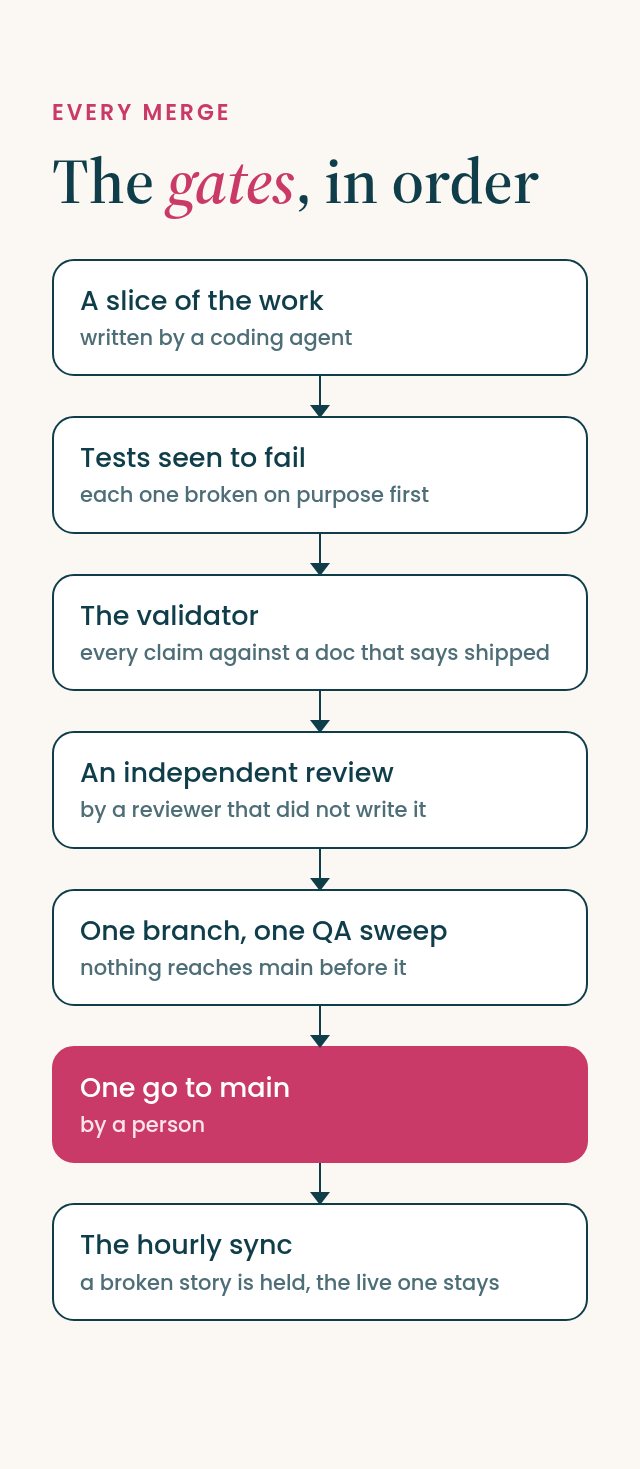
Für News waren es vier Gates. Keines davon ist neu. Neu ist, wie viel sie tragen müssen, wenn Code so schnell ankommt.
Jeder Merge, in dieser Reihenfolge
Jedes Kästchen kann die Arbeit stoppen. Nur eines davon ist eine Person, die „go nach main“ sagt. Alles davor existiert, damit es bei diesem Go um das Produkt geht und nicht um die Frage, ob der Code stimmt.
Gate 1: Tests, die wir rot gesehen haben
Ein bestehender Test sagt dir nichts, bevor du gesehen hast, wie er fehlschlägt. Und Agenten sind sehr gut darin, Tests zu schreiben, die bestehen.
In derselben Woche haben wir umgebaut, wie unser Backend die Reiseliste einer Person liest, um es etwa zehnmal schneller zu machen. Der Nachweis war ein Deep-Equal-Test: Die alte und die neue Abfrage beantworten dieselben Abfragen, und die Ausgabe muss identisch sein. Ein unabhängiges Review fand drei Lücken darin. Die Testdaten konnten bestimmte Fehler nicht von richtigen unterscheiden. Eine falsche Antwort wäre also als richtig durchgegangen.
Deshalb haben wir den Code, bevor wir ihm trauten, absichtlich kaputt gemacht, jeweils eine Sache: ein Cache-Schlüssel, der die Stadt ignoriert, Einladungen, die am falschen Trip hängen, Tagebucheinträge in falscher Reihenfolge, eine schlankere Abfrage, die Orte auslässt, eine, die deren Bilder verwirft, ein Feld, das die Anfrage auf den langsamen Pfad schicken sollte, es aber nicht tat, und eine Prüfung, die verschachtelte Felder nicht ansieht. Sieben Brüche, und jeder machte einen Test rot. Erst dann zählte der Test.
Gate 2: Ein Validator, der weiß, was wahr ist
Jede News-Story ist eine einfache Textdatei, und ein Validator liest sie, bevor irgendetwas gebaut wird. Er bleibt streng in Dingen, bei denen jeder Reviewer irgendwann ermüdet: keine Striche, britische Schreibweise, keine internen Dateipfade in etwas, das Leser sehen, und die richtige Titellänge für die Suche.
Die wichtigste Regel ist das Wahrheits-Gate. Eine Story über ein Feature nennt die Dokumente, auf denen sie beruht, und der Validator lehnt die Story ab, solange nicht jedes davon status: shipped sagt. Ein Agent kann einen überzeugenden Absatz über ein Feature schreiben, das noch auf einem Branch liegt. Er kann aber nicht dafür sorgen, dass dieses Dokument „shipped“ sagt.
Der Validator entscheidet auch, was ein Fehler bedeutet. Bei der stündlichen Synchronisation wird eine Story mit Fehler zurückgehalten: Ihre Live-Version bleibt online, und der Rest der Website läuft weiter.
Gate 3: Ein Review durch jemanden, der es nicht geschrieben hat
Jedes Arbeitspaket wurde geprüft, bevor es mit dem Rest zusammenkam, und zwar von einem Reviewer, der es nicht geschrieben hatte. Diese Trennung ist der Kern: Wer der Argumentation des Autors gefolgt ist, stimmt ihr meist auch zu.
Das Review des gesamten News-Builds ergab fünf Befunde. Zwei davon hoben Entscheidungen auf, die der Autor getroffen und festgehalten hatte:
- Eine kaputte Story hätte alles angehalten. Im ersten Entwurf stoppte ein Validierungsfehler in einer Story die gesamte stündliche Inhalts-Synchronisation, die auch unsere Stadtführer, Orte und Artikel mitnimmt. Nach dem Review läuft News in eigenen Schritten und kann nur News anhalten.
- Eine Story hätte ohne ihr Titelbild live gehen können. Nach dem Review wird eine Story erst geschrieben, wenn alle vier Größen ihres Titelbilds hochgeladen sind.
Beide Entscheidungen waren am Tag selbst vernünftig. Beide hätten in der Produktion wehgetan. Keiner der Fehler wäre durch einen Test aufgefallen, weil die Tests vom selben Autor mit demselben Entwurf geschrieben worden waren.
Gate 4: Ein Branch, ein Durchlauf
Alle sechs Arbeitspakete wurden in einen gemeinsamen Integrations-Branch gemergt, nie direkt in main. Dieser Branch übernahm main per Merge und wurde nie rebased, weil andere Arbeit darauf aufbaute. Eine Vorschau des Ganzen bekam einen QA-Durchlauf, und erst danach gab eine Person ein einziges Go nach main.
Das kostet etwas. Ein Pull Request mit 55 Commits ist schwerer zu lesen als sechs kleine, und der Durchlauf wartet auf das langsamste Arbeitspaket. Dafür bekommt man ein Bild des gesamten Systems, getestet so, wie Reisende ihm begegnen, statt sechs Bilder, die jeweils für sich korrekt sind.
Der Bug, der trotzdem durchkam
News wurde um 13:10 Uhr gemergt. Um 13:51 Uhr schlug die stündliche Inhalts-Synchronisation schon beim allerersten Schritt fehl, noch bevor sie etwas synchronisiert hatte. Jeder spätere Lauf wäre genauso gescheitert.
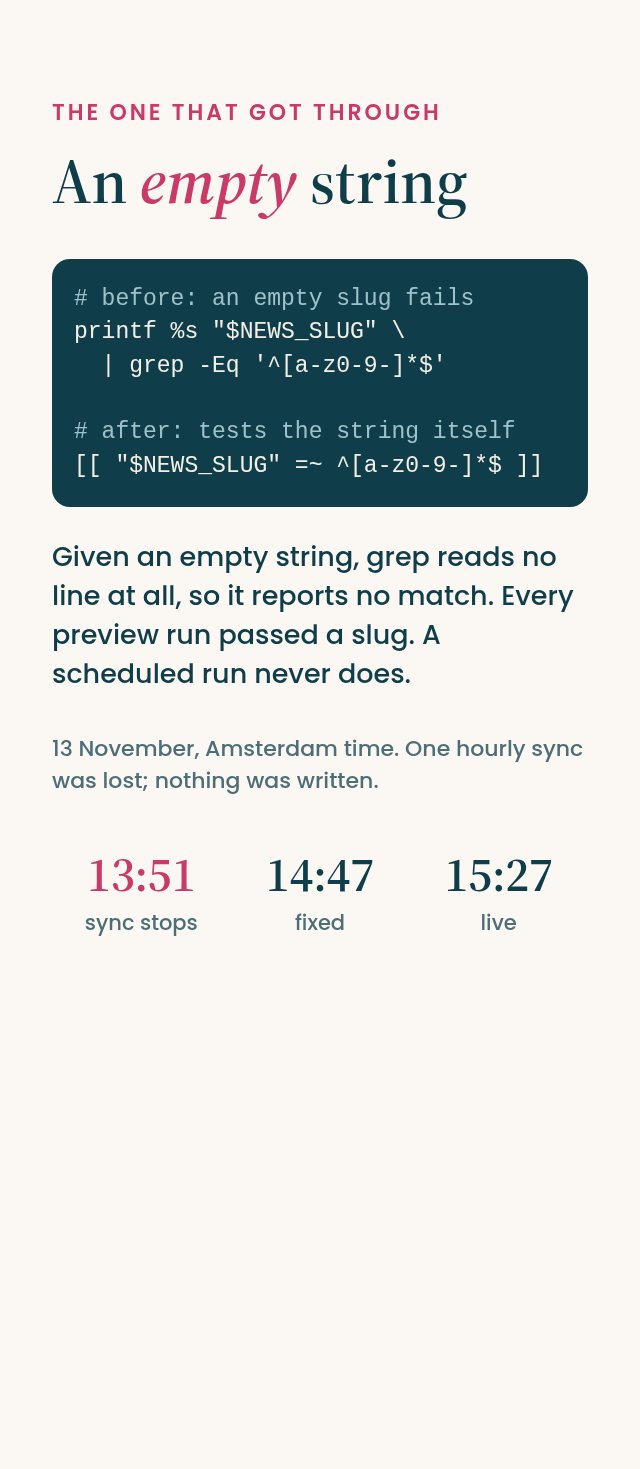
Die Ursache war eine Zeile, eine Prüfung, ob der optionale Slug einer einzelnen zu synchronisierenden Story nur sichere Zeichen enthält:
Eine leere Zeichenkette
printf %s "$NEWS_SLUG" | grep -Eq '^[a-z0-9-]*$' sieht so aus, als würde ein leerer Slug erlaubt, weil das Muster eine leere Zeile trifft. Bekommt grep aber eine leere Zeichenkette, liest es gar keine Zeile, meldet also keinen Treffer, und die Prüfung schlägt fehl. Jeder Vorschau-Lauf hatte einen Slug übergeben. Ein geplanter Lauf setzt nie einen.
Die Korrektur testet die Zeichenkette selbst, [[ "$NEWS_SLUG" =~ ^[a-z0-9-]*$ ]], und wurde um 14:47 Uhr gemergt. Unser Alarm hatte den Fehler gemeldet, ein stündlicher Sync ging verloren, es wurde nichts geschrieben und nichts beschädigt. Die erste Synchronisation nach der Korrektur veröffentlichte News um 15:27 Uhr.
Das Review hatte dafür gesorgt, dass News nur News anhalten kann. Dann kam eine neue Prüfung in den gemeinsamen ersten Schritt der Synchronisation, vor alle eigenen Schritte von News, und hielt alles an. Unsere Gates haben getestet, was die Agenten ausgeführt hatten. Nichts hat getestet, was der Zeitplan ausführen würde.
Was ich anders machen würde
Zwei Dinge. Der erste Test jeder Eingabeprüfung sollte die leere Eingabe sein, vor dem Normalfall. Und eine Änderung an einem geplanten Job sollte einmal in genau der Form laufen, die der Zeitplan verwendet, ohne jede Eingabe, bevor sie gemergt wird. Beides braucht kein intelligenteres Modell. Beides sind Prüfungen.
Das Fazit
Du kannst Agenten-Code nur so schnell ausliefern, wie deine Prüfungen ihn absichern können. Investiere deine Zeit in die Prüfungen: Tests, die du rot gesehen hast, Validatoren, die wissen, was wahr ist, ein Reviewer, der den Code nicht geschrieben hat, und ein Durchlauf des Ganzen, bevor es ausgeliefert wird.
Häufige Fragen
Können Coding-Agenten Produktionscode sicher ausliefern?
Ja, wenn nichts, was sie schreiben, ohne Prüfungen in die Produktion gelangt, an denen sie nicht vorbeireden können: Tests, die du rot gesehen hast, ein unabhängiges Review und Validatoren, die Aussagen gegen die Wirklichkeit prüfen. Die Sicherheit steckt in den Prüfungen, nicht im Modell, und die Prüfungen müssen abdecken, wie der Code tatsächlich läuft, nicht nur, wie er getestet wurde.
Worin unterscheidet sich Vibe Coding vom Arbeiten mit Coding-Agenten?
Vibe Coding akzeptiert, was das Modell schreibt, weil es zu funktionieren scheint. Wer mit Agenten arbeitet, legt zuerst fest, was wahr sein muss, schreibt dafür Prüfungen und lässt die Arbeit nur durch, wenn sie bestehen.
Woher weißt du, dass ein Test einen Bug finden würde?
Brich den Code absichtlich und schau zu, wie der Test rot wird. Ein Test, den du nie fehlschlagen gesehen hast, beweist nichts.
Stippl ist der soziale KI-Reiseplaner. Reisende beschreiben eine Reise in ihren eigenen Worten, die KI erstellt den Plan, und die Menschen, mit denen sie reisen, planen, buchen und teilen ihn gemeinsam. Mehr als 1,5 Millionen Reisende haben ihre Reisen mit Stippl geplant. Stippl ist kostenlos für iOS, Android und im Web.