Stippl is de sociale AI-reisplanner. We bouwen hem met coding agents, en niets wat zij schrijven bereikt reizigers zonder langs de gates te komen: tests die we hebben zien falen, een validator die elke bewering controleert, een review door iemand die de code niet schreef en één QA-ronde voordat er iets gemerged wordt. Zo ging onze redactie in ongeveer 23 uur live, en zo glipte er toch één bug doorheen.
Op 12 november om 16:37 gaf ik het go voor Stippl News, het onderdeel dat je nu leest. De volgende dag om 15:27 stond het live in het Engels, Nederlands en Duits: een feed, verhaalpagina's, covers, een sync van platte bestanden naar de site en de taak die nieuwe verhalen voorbereidt. Zes stukken werk in één pull request van 55 commits, geschreven door coding agents. Over die snelheid praat iedereen. Het is ook het minst interessante deel.
Snelheid was nooit het probleem
We zijn een klein team dat een AI-reisplanner bouwt voor mensen die samen reizen plannen. Met agents bouwen we in een tempo dat een team van onze omvang anders nooit haalt. Het risico is het risico waar het hele vak het dit jaar over heeft: vibe coding, accepteren wat het model schrijft omdat het draait.
Een agent schrijft vloeiende code en een even vloeiende uitleg erbij. Allebei klinken ze goed. Geen van beide is bewijs. De vraag die mij bezighoudt is dus niet hoe goed het model is, maar wat er waar moet zijn voordat zijn werk een reiziger bereikt, en wat dat voor ons controleert.
Voor News waren dat vier gates. Geen ervan is nieuw. Nieuw is hoeveel er op ze rust nu code zo snel binnenkomt.
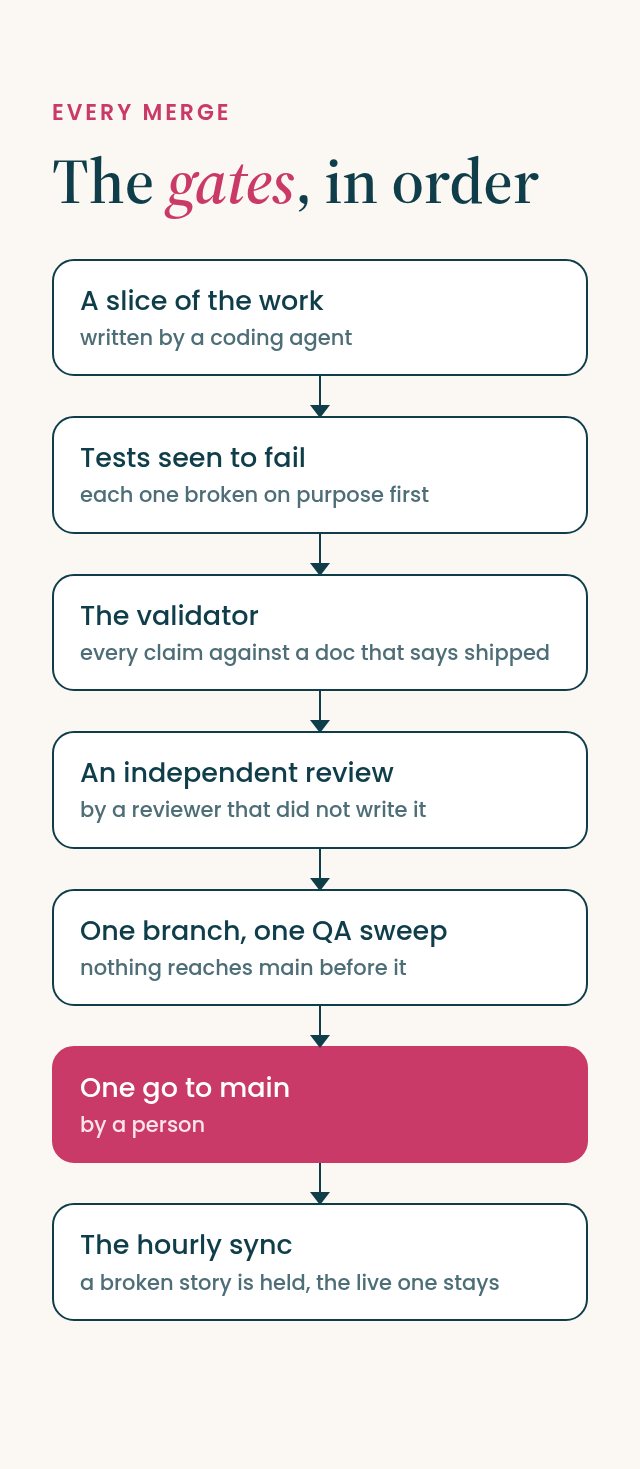
Elke merge, in volgorde
Elk vakje kan het werk tegenhouden. Maar één ervan is een mens die go zegt naar main. Alles daarvoor bestaat zodat dat go over het product gaat, en niet over de vraag of de code klopt.
Gate 1: tests die we hebben zien falen
Een test die slaagt, zegt niets tot je hem hebt zien falen. En agents zijn heel goed in het schrijven van tests die slagen.
Dezelfde week bouwden we om hoe onze backend de reislijst van een reiziger ophaalt, zodat dat ongeveer tien keer sneller gaat. Het bewijs was een deep-equal-test: de oude en de nieuwe manier van ophalen beantwoorden dezelfde queries, en de uitkomst moet identiek zijn. Een onafhankelijke review vond er drie gaten in. De testdata kon bepaalde fouten niet van elkaar onderscheiden, dus een fout antwoord zou er precies zo uitzien als het goede.
Dus voordat we erop vertrouwden, braken we de code expres, één ding tegelijk: een cache-sleutel die de stad negeert, uitnodigingen aan de verkeerde reis, dagboeken in de verkeerde volgorde, een lichtere variant die plaatsen overslaat, een variant die hun afbeeldingen laat vallen, een veld dat het verzoek naar het trage pad had moeten sturen maar dat niet deed, en een controle die niet in geneste velden kijkt. Zeven breuken, en elke keer werd er een test rood. Pas toen telde de test.
Gate 2: een validator die weet wat waar is
Elk News-verhaal is een plat tekstbestand, en een validator leest het voordat er iets gebouwd wordt. Hij is onvermoeibaar streng op punten waar elke reviewer na een tijdje de puf voor verliest: geen gedachtestreepjes, Britse spelling, geen interne bestandspaden in iets wat een lezer ziet, en de juiste titellengte voor zoekmachines.
De belangrijkste regel is de waarheidsgate. Een verhaal over een functie noemt de documenten waarop het steunt, en de validator weigert het verhaal zolang niet elk van die documenten status: shipped zegt. Een agent kan een overtuigende alinea schrijven over een functie die nog op een branch staat. Hij kan er niet voor zorgen dat dat document shipped zegt.
De validator bepaalt ook wat een fout betekent. In de uurlijkse sync wordt een verhaal met een fout tegengehouden: de live versie blijft staan en de rest van de site draait gewoon door.
Gate 3: een review door iemand die het niet schreef
Elk stuk werd gereviewd voordat het bij de rest kwam, door een reviewer die het niet zelf had geschreven. Die scheiding is precies het punt: een reviewer die de redenering van de auteur heeft gevolgd, gaat er al snel in mee.
De review van de complete News-build leverde vijf bevindingen op, en twee daarvan draaiden beslissingen terug die de auteur had genomen en vastgelegd:
- Eén kapot verhaal had alles stilgelegd. In het eerste ontwerp hield een validatiefout in één verhaal de hele uurlijkse contentsync tegen, en die sync brengt ook onze stadsgidsen, plaatsen en artikelen live. Sinds de review draait News in eigen stappen en kan het alleen News stilleggen.
- Een verhaal had zonder cover live kunnen gaan. Sinds de review wordt een verhaal pas weggeschreven als alle vier de formaten van de cover zijn geüpload.
Allebei waren het op dat moment redelijke keuzes. Allebei hadden ze in productie pijn gedaan. En geen test had ze gevangen, want die tests waren door dezelfde auteur geschreven, tegen hetzelfde ontwerp.
Gate 4: één branch, één ronde
Alle zes de stukken werden gemerged in één integratiebranch, nooit rechtstreeks in main. Die branch haalde main binnen met een merge en werd nooit gerebased, omdat er ander werk op voortbouwde. Eén preview van het geheel kreeg één QA-ronde, en pas daarna gaf één persoon één go naar main.
Dat heeft een prijs. Een pull request van 55 commits leest lastiger dan zes kleine, en de ronde wacht op het traagste stuk. Maar je krijgt er één beeld van het hele systeem voor terug, getest zoals reizigers het tegenkomen, in plaats van zes beelden die elk op zich kloppen.
De bug die er toch doorheen glipte
News werd om 13:10 gemerged. Om 13:51 faalde de uurlijkse contentsync al bij de allereerste stap, nog voordat er iets gesynchroniseerd was. Elke volgende run zou op precies dezelfde manier zijn gefaald.
De oorzaak was één regel: een controle of de optionele slug van één te synchroniseren verhaal alleen veilige tekens bevat.
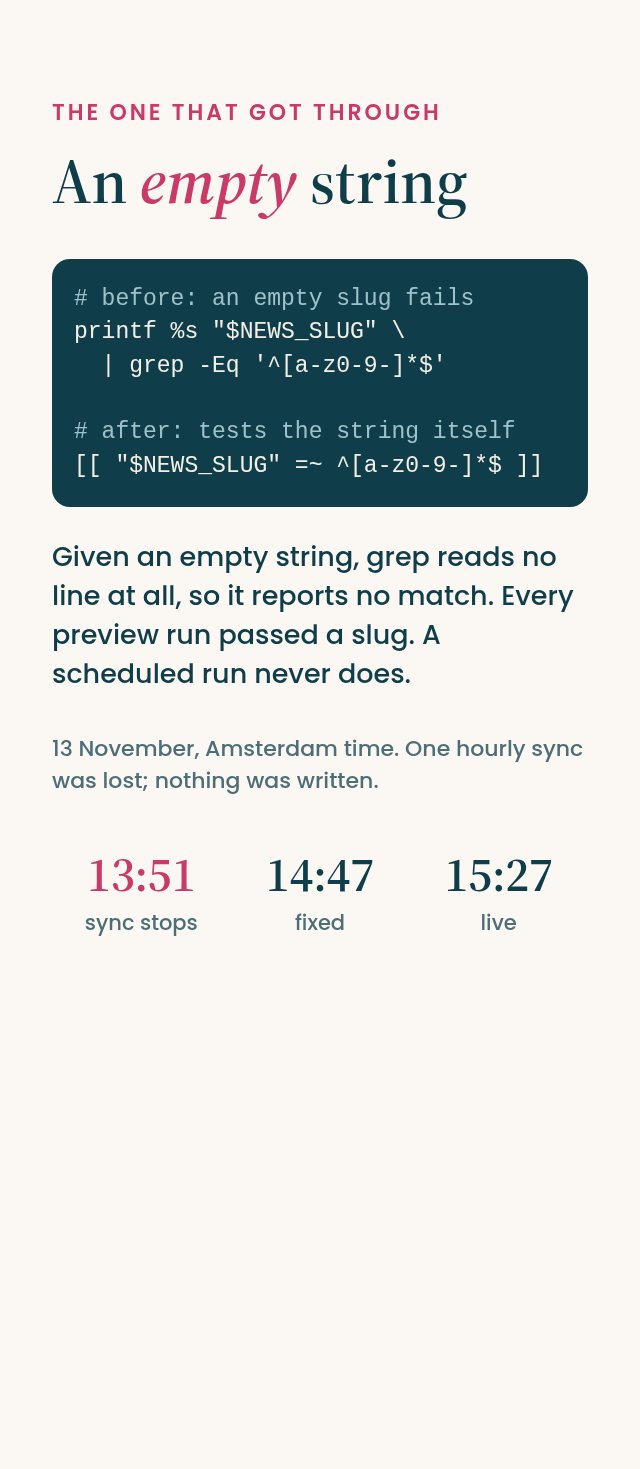
Een lege string
printf %s "$NEWS_SLUG" | grep -Eq '^[a-z0-9-]*$' lijkt een lege slug toe te staan, want het patroon matcht een lege regel. Maar krijgt grep een lege string, dan leest hij helemaal geen regel, meldt hij dus geen match en faalt de controle. Elke preview-run had een slug meegekregen. Een geplande run zet er nooit een.
De fix test de string zelf, [[ "$NEWS_SLUG" =~ ^[a-z0-9-]*$ ]], en werd om 14:47 gemerged. Onze alerting had de fout gemeld, er ging één uurlijkse sync verloren, er werd niets weggeschreven en niets beschadigd. De eerste sync na de fix zette News om 15:27 live.
De review had ervoor gezorgd dat News alleen News kon stilleggen. Daarna kwam er een nieuwe controle in de gedeelde eerste stap van de sync, vóór alle stappen van News zelf, en die legde alles stil. Onze gates testten wat de agents hadden gedraaid. Niets testte wat het schema zou draaien.
Wat ik anders zou doen
Twee dingen. De eerste test van elke inputcontrole hoort de lege input te zijn, nog vóór het normale pad. En een wijziging aan een geplande taak moet vóór de merge één keer draaien in precies de vorm die het schema gebruikt, dus zonder enige input. Geen van beide vraagt om een slimmer model. Het zijn allebei checks.
De conclusie
Je kunt agentcode maar zo snel uitrollen als je checks ervoor kunnen instaan. Steek je tijd dus in de checks: tests die je hebt zien falen, validators die weten wat waar is, een reviewer die de code niet schreef, en één ronde over het geheel voordat het live gaat.
Vragen die mensen stellen
Kunnen coding agents veilig productiecode opleveren?
Ja, zolang niets wat ze schrijven productie bereikt zonder checks waar ze zich niet uit kunnen praten: tests die je hebt zien falen, een onafhankelijke review en validators die beweringen toetsen aan de werkelijkheid. De veiligheid zit in de checks, niet in het model, en die checks moeten dekken hoe de code straks echt draait, niet alleen hoe hij getest is.
Wat is het verschil tussen vibe coding en engineering met coding agents?
Bij vibe coding accepteer je wat het model schrijft, omdat het lijkt te werken. Bij engineering met agents bepaal je eerst wat er waar moet zijn, schrijf je daar checks voor en laat je het werk pas door als die slagen.
Hoe weet je of een test een bug zou vangen?
Breek de code expres en kijk of de test rood wordt. Een test die je nooit hebt zien falen, bewijst niets.
Stippl is de sociale AI-reisplanner. Reizigers beschrijven een reis in hun eigen woorden, de AI maakt het plan, en de mensen met wie ze reizen doen mee om samen te plannen, te boeken en te delen. Meer dan 1,5 miljoen reizigers hebben hun reizen met Stippl gepland. Het is gratis op iOS, Android en het web.